Nos sentamos con el comité de dirección de una industrial de 240 empleados en febrero del año pasado. Pregunta sencilla: ¿cuántas herramientas con algún componente algorítmico hay funcionando aquí ahora mismo? La respuesta del CIO fue "cuatro, cinco como mucho". El recuento final, tras seis semanas de trabajo, fue de treinta y una.
Esa brecha entre lo que una organización cree tener y lo que realmente tiene corriendo explica por qué casi ningún inventario de sistemas de IA en tu empresa construido desde arriba sirve para nada. Se construyen preguntando a los responsables de área en lugar de mirar facturas, logs de acceso y extensiones de navegador instaladas.
Lo que viene a continuación es el método de tres capas que aplicamos nosotros. No es una checklist bonita para enseñar en un consejo (de esas tenemos varias archivadas y ninguna sobrevivió a su segunda revisión). Es un sistema que aguanta una verificación real, con fechas, responsables y evidencias archivadas.
Qué cuenta como sistema de IA y qué queda fuera del registro
Un inventario de sistemas de IA es el registro interno donde una organización documenta cada caso de uso con componente algorítmico que tiene activo: qué función cumple, quién responde de él, qué datos procesa, qué proveedor lo suministra y qué nivel de riesgo tiene según el marco europeo.
¿Cuenta una macro de Excel con doscientas reglas condicionales? ¿Cuenta el corrector del CRM? ¿Cuenta el filtro antispam que nadie ha configurado en nueve años?
El criterio que aplicamos es funcional, no tecnológico: entra todo aquello que produce una inferencia, recomendación, puntuación, predicción o contenido a partir de datos, y cuya salida influye en una decisión que afecta a una persona, sea cliente, candidato, empleado o proveedor. Si la salida solo mueve un dato de una columna a otra, fuera.
Este filtro deja dentro cosas que incomodan. El scoring de impagos que un analista programó en 2019 con una regresión logística entra. La herramienta de resumen de reuniones que alguien instaló el mes pasado, también. Y ahí es donde empiezan las discusiones de verdad.
La frontera entre automatización clásica y modelo entrenado
La distinción técnica es nítida: un sistema basado en reglas escritas por una persona hace exactamente lo que está escrito; un modelo entrenado deriva su comportamiento de datos históricos y puede equivocarse de formas que nadie programó.
El Reglamento Europeo de Inteligencia Artificial, el 2024/1689, en vigor desde el 1 de agosto de 2024, excluye explícitamente los sistemas puramente deterministas basados en reglas definidas por humanos. Pero cuidado con la zona gris. Un árbol de decisión escrito a mano es determinista; ese mismo árbol generado automáticamente desde un histórico de 80.000 registros, no.
Nuestra recomendación práctica: ante la duda, inclúyelo con la etiqueta "frontera" y una nota de dos líneas explicando por qué dudas. Cuesta tres minutos. Sacar un elemento del catálogo seis meses después es trivial; descubrir que faltaba cuando llega una reclamación, no.
Las herramientas que ya usan tus equipos sin que nadie las haya aprobado
Aquí está el verdadero agujero. En las organizaciones que hemos revisado, entre el 35% y el 50% de los casos de uso detectados no habían pasado por ningún proceso de aprobación interna. Son estimaciones nuestras sobre una muestra de 34 compañías, no un estudio académico, pero el patrón se repite con una consistencia incómoda.
Ocurre así: una persona de marketing se suscribe a un asistente generativo con su tarjeta corporativa, 19 euros al mes. Funciona. Se lo cuenta a dos compañeras. En cuatro meses hay once licencias individuales, ninguna con contrato de encargado de tratamiento, y documentación comercial sensible viajando a un proveedor que nadie ha evaluado.
Antes de preguntar a nadie, pedimos tres cosas a finanzas y a IT: el detalle de suscripciones SaaS de los últimos doce meses, el listado de extensiones de navegador instaladas y los logs de dominios consultados desde la red corporativa. Si quieres entender la magnitud del fenómeno antes de empezar, documentamos el caso de los empleados que usan IA sin que lo sepas sin que lo sepas con ejemplos concretos de cómo se cuela cada herramienta y por qué los equipos no la declaran voluntariamente. La conclusión corta: no lo ocultan por malicia, lo ocultan porque declararlo les retrasa el trabajo.
Capa 1: el censo de casos de uso y sus campos mínimos
La primera capa responde a una sola pregunta: qué hay, dónde está y quién responde de ello. Nada de riesgo todavía. Nada de cumplimiento normativo. Solo recuento.
Mezclar el recuento con la clasificación es el error número uno. Cuando pides a un responsable de área que declare una herramienta y simultáneamente le anuncias que eso puede derivar en obligaciones documentales, la declaración se vuelve selectiva. Primero cuenta. Ordena después, con los datos ya encima de la mesa.
Total, que esta primera fase debe ser lo más indolora posible. Un formulario de once campos, diez minutos por sistema declarado, y nadie juzgando a nadie mientras dura.
Qué información necesita cada ficha para ser útil seis meses después
Estos son los once campos que han sobrevivido a nuestras propias iteraciones. Empezamos con veintitrés en 2022. Nadie los rellenaba (y los que sí, los rellenaban con "varios" y "pendiente de confirmar").
- Identificador interno y nombre coloquial
- Función de negocio que resuelve
- Proveedor y modelo subyacente
- Departamento usuario y responsable nominal
- Fecha de puesta en marcha
- Tipos de datos que procesa
- Personas afectadas por su salida
- Grado de supervisión humana
- Decisión que condiciona
- Coste anual y forma de contratación
- Estado: producción, piloto, abandonado
El campo "decisión que condiciona" es el que más resistencia genera y el más valioso. Obliga a escribir una frase del tipo "determina qué candidaturas ve el reclutador en primer lugar". Esa frase, luego, resuelve la clasificación de riesgo casi sin discusión.
Ojo con "estado: abandonado". Encontramos pilotos formalmente cerrados cuyas claves de API seguían activas catorce meses después. Uno de ellos, en una aseguradora mediana, continuaba procesando unos 400 documentos semanales que ya nadie leía.
Quién rellena, quién valida y cada cuánto se revisa
Rellena quien usa. Valida quien no usa. Esa separación es lo que convierte una hoja de cálculo en gobernanza.
El reparto que funciona: el usuario operativo redacta, el responsable de la función de negocio firma, y una tercera persona independiente (compliance, legal, seguridad, o un externo si no hay estructura interna) contrasta lo declarado contra las fuentes objetivas de la capa cero: facturas, logs, contratos. Sin ese contraste, lo que tienes es un cuestionario de autoevaluación.
Si quieres profundizar en cómo encaja este reparto de roles con el resto del marco documental, desarrollamos el enfoque completo en nuestra metodología de inventario de IA y evidencias, matrices de responsabilidad incluidas. Lo esencial cabe en una línea: la validación nunca puede recaer en quien se beneficia del uso de la herramienta.
Periodicidad: revisión trimestral de lo clasificado como riesgo elevado, semestral del resto, y revisión inmediata ante cuatro disparadores: nuevo proveedor, cambio de versión del modelo, ampliación de la base de personas afectadas o incidente.
Capa 2: clasificación por nivel de riesgo
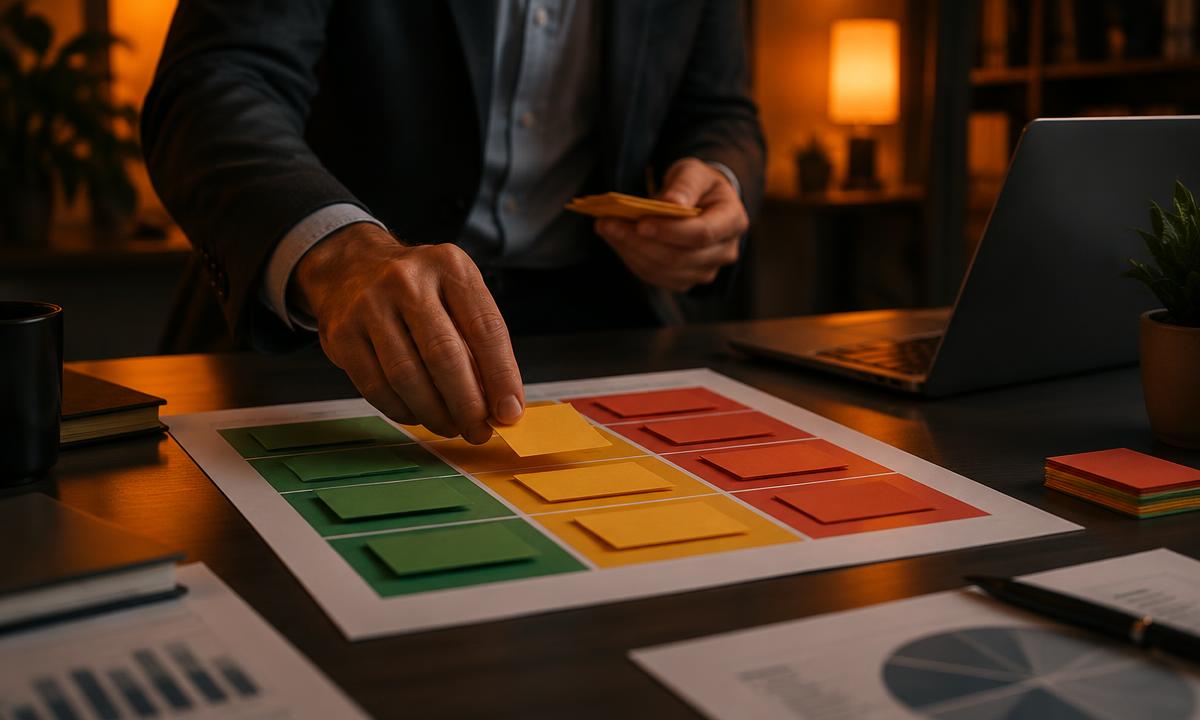
Con el recuento cerrado, toca ordenar. El marco europeo establece cuatro niveles y las consecuencias de acertar o fallar no son simétricas.
Las prohibiciones del artículo 5 son aplicables desde el 2 de febrero de 2025. Las obligaciones de los modelos de propósito general, desde el 2 de agosto de 2025. Las de alto riesgo del Anexo III, desde el 2 de agosto de 2026. El régimen sancionador llega hasta 35 millones de euros o el 7% de la facturación anual global en el caso de las prácticas prohibidas, y hasta 15 millones o el 3% para el incumplimiento de otras obligaciones.
| Nivel | Qué implica | Ejemplo típico en una empresa |
|---|---|---|
| Inaceptable (prohibido) | Uso vetado, sin mitigación posible | Reconocimiento de emociones de la plantilla en el puesto de trabajo |
| Alto riesgo | Gestión de riesgos, documentación técnica, supervisión humana y evaluación de conformidad | Cribado automático de candidaturas en un proceso de selección |
| Riesgo limitado | Obligaciones de transparencia del artículo 50 | Chatbot de atención al cliente en la web corporativa |
| Riesgo mínimo | Sin obligaciones específicas, pero debe constar en el censo | Filtro antispam del correo o corrector predictivo interno |
Prácticas prohibidas, alto riesgo, riesgo limitado y mínimo
El nivel prohibido incluye, entre otros supuestos, el reconocimiento de emociones en el entorno laboral y educativo, la puntuación social y la inferencia de datos sensibles mediante categorización biométrica. Esto no se mitiga ni se documenta: se apaga.
Alto riesgo abarca las ocho áreas del Anexo III (empleo y gestión de trabajadores, acceso a servicios esenciales, educación, infraestructuras críticas, migración, justicia, biometría y aplicación de la ley) más los sistemas integrados en productos ya sujetos a evaluación de conformidad. Si sitúas algo aquí, asumes gestión de riesgos, gobernanza de datos, documentación técnica, registro de eventos, supervisión humana y evaluación de conformidad.
Riesgo limitado implica obligaciones de transparencia del artículo 50: avisar de que se interactúa con una máquina, etiquetar contenido sintético. Y riesgo mínimo, donde cae la enorme mayoría del catálogo típico, no conlleva obligaciones específicas. Lo cual no significa que pueda quedar sin documentar.
Los dos errores de clasificación que se repiten en casi todas las empresas
Error uno: ordenar por la herramienta en lugar de por el uso. El mismo asistente generativo es riesgo mínimo redactando borradores internos y potencialmente alto riesgo resumiendo evaluaciones de desempeño. La unidad de análisis es el caso de uso, no el contrato con el proveedor. Nos costó un año entender esto bien.
Error dos, más sutil: dar por buena la etiqueta que te pone el vendedor. Un proveedor te dirá que su producto "no es de alto riesgo" porque esa afirmación es cómoda para él. Pero la calificación depende del contexto de despliegue, y el contexto lo pones tú.
Reconozco que nuestra primera versión del método ordenaba por herramienta. Parecía eficiente: un expediente por contrato, menos trabajo. Hasta que en una revisión de 2023 detectamos que un único producto estaba dando soporte a siete usos distintos en cuatro departamentos, dos de ellos con impacto directo en decisiones de contratación. Reescribimos la metodología entera desde cero.
¿Funciona siempre el enfoque por uso? No. Multiplica el número de expedientes por tres o cuatro, y en organizaciones con cientos de casos se vuelve pesado. La alternativa es agrupar por familias de uso equivalentes, pero exige criterio experto para definir esas familias (y ahí es donde se cuela la tentación de agrupar lo que no es equiparable).
Capa 3: trazabilidad de datos, proveedores y modelos de terceros
La tercera capa es la que casi nadie construye y la única que sirve cuando llega una pregunta incómoda.
Consiste en documentar, para cada caso de uso, de dónde salen los datos de entrada, qué recorrido hacen, quién los procesa por el camino y qué modelo concreto, con versión identificada, produce la salida. Suena obvio. Luego preguntas por la versión y nadie la sabe.
Responsabilidad compartida cuando el modelo no es tuyo
Si despliegas un modelo ajeno, el reglamento te sitúa como responsable del despliegue, con obligaciones propias que no desaparecen porque el proveedor tenga las suyas. Tú respondes del contexto de uso, de la supervisión humana efectiva y de la información que das a las personas afectadas.
Lo que el proveedor debe entregarte, y conviene exigir por escrito: identificación de la versión del modelo, política de retención y de entrenamiento con tus datos, ubicación de procesamiento, plazo de notificación de incidentes y preaviso de cambios sustanciales.
Un detalle que casi siempre se pasa: los cambios silenciosos de versión. En una revisión de abril de 2024 encontramos un flujo de clasificación de reclamaciones cuyo modelo subyacente había cambiado dos veces en cinco meses sin aviso. La precisión medida en las métricas internas del cliente había caído un 9% y nadie lo había relacionado con nada.
Evidencias que conviene archivar desde el primer día
Una revisión externa no evalúa tu buena intención: evalúa lo que puedes demostrar con fecha. Nuestro paquete mínimo por caso de uso, en repositorio con control de versiones:
- Declaración de censo firmada, con fecha
- Justificación escrita del nivel de riesgo asignado
- Contrato y anexo de tratamiento de datos
- Documentación técnica recibida del proveedor
- Registro de pruebas previas al despliegue
- Acta de validación independiente
- Historial de versiones del modelo
- Materiales de formación entregados a los usuarios
Tres años de conservación como suelo, más el tiempo que el caso de uso siga activo. Y un detalle de formato que importa más de lo que parece: nombres de archivo con fecha ISO al principio. Un repositorio sin convención de nombres es un repositorio que nadie consulta.
Integrar las tres capas en un registro vivo
Las tres capas no son tres documentos. Son tres vistas de la misma tabla, y esa es la diferencia entre un sistema que se mantiene y uno que se abandona en el segundo trimestre.
Si el censo vive en un Excel de operaciones, la clasificación en un informe de compliance y las evidencias en una carpeta compartida de IT, lo que tienes son tres fuentes de verdad que divergirán en ocho semanas. Lo hemos visto bastantes veces como para afirmarlo sin matices.
Plantilla operativa y ciclo de actualización
Una tabla única. Una fila por caso de uso. Columnas agrupadas en tres bloques: identificación, clasificación, trazabilidad. Y campos calculados que marcan en rojo lo que tiene la revisión vencida.
| Bloque | Campos clave | Responsable | Revisión |
|---|---|---|---|
| Identificación | Uso, área, proveedor, estado | Usuario operativo | Semestral |
| Clasificación | Nivel, justificación, obligaciones | Compliance o legal | Trimestral |
| Trazabilidad | Datos, versión, evidencias | IT y seguridad | Trimestral |
Herramienta: la que ya uses. Una hoja de cálculo bien gobernada supera a una plataforma de GRC que nadie abre. Empezamos siempre en hoja de cálculo y migramos a partir de unos 60 o 70 casos de uso activos, cuando el control de concurrencia empieza a fallar.
El ciclo que sostiene esto es bastante simple: declaración obligatoria antes de contratar cualquier herramienta nueva, revisión programada por bloques, y una sesión anual de barrido completo contra facturación y logs. Esa sesión anual es irrenunciable. Es donde aparece lo que nadie declaró.
Señales de que tu registro ha dejado de reflejar la realidad
Hay cinco síntomas que detectamos con fiabilidad razonable:
Ninguna entrada nueva en los últimos cuatro meses, en una organización que sigue contratando software. Ningún caso de uso retirado nunca, porque los catálogos reales tienen bajas y los ficticios solo crecen. Más del 80% de los sistemas etiquetados como riesgo mínimo sin justificación escrita. Campos de versión de modelo vacíos o con el valor "última". Y el más revelador: cuando preguntas a un usuario operativo por su herramienta y describe algo que no coincide con lo declarado.
Ese último lo medimos con una muestra de cinco expedientes al azar por trimestre, conversación de diez minutos con el usuario real. Si dos de cinco no cuadran, el catálogo entero necesita barrido.
Volviendo a la industrial de las treinta y una herramientas: dieciocho meses después tienen treinta y siete sistemas activos documentados, nueve retirados, y la última revisión trimestral detectó dos discrepancias menores. No es perfecto. Es, en cambio, algo que refleja la realidad con un desfase de semanas en lugar de años. Y eso, cuando alguien llame a la puerta con preguntas, es exactamente la diferencia que cuenta.